 规则与目标
胜负目标 × 资源约束
胜负目标不是对玩家努力的奖励,而是把某个可复核的终局事实映射为胜、负、和三类结果的规则;映射必须唯一,否则同一事实可被判成两种结果。误把过程表现当成结算依据,会使结果无法复核;正确做法是在对局结束前就固定判定事实与归属对象。
资源约束是让行动在额度不足时被规则拒绝的资格条件,不只是显示余量的数字;它靠统一计量与批准时扣减成立。若只展示余量却允许透支或事后扣减,超额行动会被放过,取舍失效;正确做法是在行动获批的同一时点核对并扣除。
规则与目标胜负目标不是对玩家努力的奖励,而是把某个可复核的终局事实映射为胜、负、和三类结果的规则;映射必须唯一,否则同一事实可被判成两种结果。误把过程表现当成结算依据,会使结果无法复核;正确做法是在对局结束前就固定判定事实与归属对象。
资源约束是让行动在额度不足时被规则拒绝的资格条件,不只是显示余量的数字;它靠统一计量与批准时扣减成立。若只展示余量却允许透支或事后扣减,超额行动会被放过,取舍失效;正确做法是在行动获批的同一时点核对并扣除。
 规则与目标
资源约束是让行动在额度不足时被规则拒绝的资格条件,不只是显示余量的数字;它靠统一计量与批准时扣减成立。若只展示余量却允许透支或事后扣减,超额行动会被放过,取舍失效;正确做法是在行动获批的同一时点核对并扣除。
风险回报是把同一选择的全部分支及其代价与所得并列的说明结构,其成立依赖分支互斥且覆盖所有可能结果。若只展示有利分支而略去失败分支,选择会被误判为稳赚;正确做法是先列全结果,再比较各分支的代价与所得,不用单一结果代表整体。
 规则与目标
风险回报是把同一选择的全部分支及其代价与所得并列的说明结构,其成立依赖分支互斥且覆盖所有可能结果。若只展示有利分支而略去失败分支,选择会被误判为稳赚;正确做法是先列全结果,再比较各分支的代价与所得,不用单一结果代表整体。
规则例外是主规则适用范围的收缩:它只排除主规则在特定对象、场景或时点上的适用,不自动生成替代处理;其成立依赖例外条件可独立判定。误把例外当成额外权利,会让本不该适用主规则的情形仍按主规则处理;正确做法是先核对主规则条件,再确认例外是否排除,替代结果另看条款。
 规则与目标
规则例外是主规则适用范围的收缩:它只排除主规则在特定对象、场景或时点上的适用,不自动生成替代处理;其成立依赖例外条件可独立判定。误把例外当成额外权利,会让本不该适用主规则的情形仍按主规则处理;正确做法是先核对主规则条件,再确认例外是否排除,替代结果另看条款。
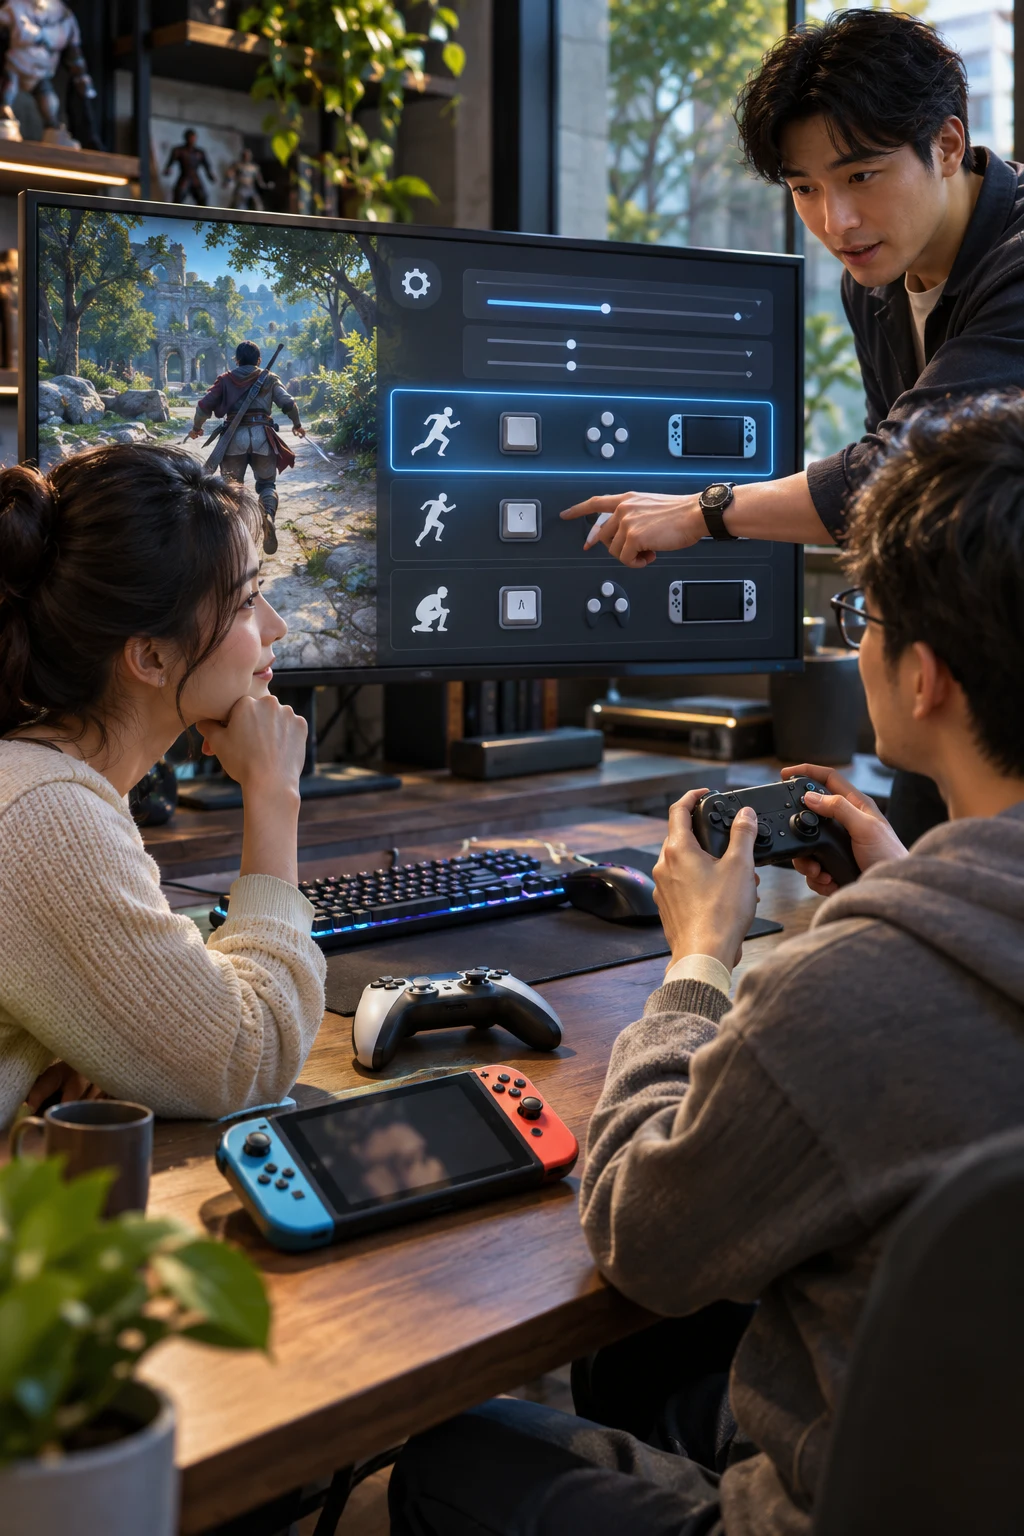
输入映射是把连续输入按阈值切成离散动作的判定规则,不只是按键对照;它靠进入阈值与退出阈值分开设定成立。若只写方向不写阈值,轻推或临界抖动会被反复识别成触发与释放;正确做法是同时规定触发与释放的门槛及回差。
规则与目标胜负目标不是对玩家努力的奖励,而是把某个可复核的终局事实映射为胜、负、和三类结果的规则;映射必须唯一,否则同一事实可被判成两种结果。误把过程表现当成结算依据,会使结果无法复核;正确做法是在对局结束前就固定判定事实与归属对象。
风险回报是把同一选择的全部分支及其代价与所得并列的说明结构,其成立依赖分支互斥且覆盖所有可能结果。若只展示有利分支而略去失败分支,选择会被误判为稳赚;正确做法是先列全结果,再比较各分支的代价与所得,不用单一结果代表整体。
规则与目标资源约束是让行动在额度不足时被规则拒绝的资格条件,不只是显示余量的数字;它靠统一计量与批准时扣减成立。若只展示余量却允许透支或事后扣减,超额行动会被放过,取舍失效;正确做法是在行动获批的同一时点核对并扣除。
规则例外是主规则适用范围的收缩:它只排除主规则在特定对象、场景或时点上的适用,不自动生成替代处理;其成立依赖例外条件可独立判定。误把例外当成额外权利,会让本不该适用主规则的情形仍按主规则处理;正确做法是先核对主规则条件,再确认例外是否排除,替代结果另看条款。
规则与目标风险回报是把同一选择的全部分支及其代价与所得并列的说明结构,其成立依赖分支互斥且覆盖所有可能结果。若只展示有利分支而略去失败分支,选择会被误判为稳赚;正确做法是先列全结果,再比较各分支的代价与所得,不用单一结果代表整体。
输入映射是把连续输入按阈值切成离散动作的判定规则,不只是按键对照;它靠进入阈值与退出阈值分开设定成立。若只写方向不写阈值,轻推或临界抖动会被反复识别成触发与释放;正确做法是同时规定触发与释放的门槛及回差。
规则与目标规则例外是主规则适用范围的收缩:它只排除主规则在特定对象、场景或时点上的适用,不自动生成替代处理;其成立依赖例外条件可独立判定。误把例外当成额外权利,会让本不该适用主规则的情形仍按主规则处理;正确做法是先核对主规则条件,再确认例外是否排除,替代结果另看条款。
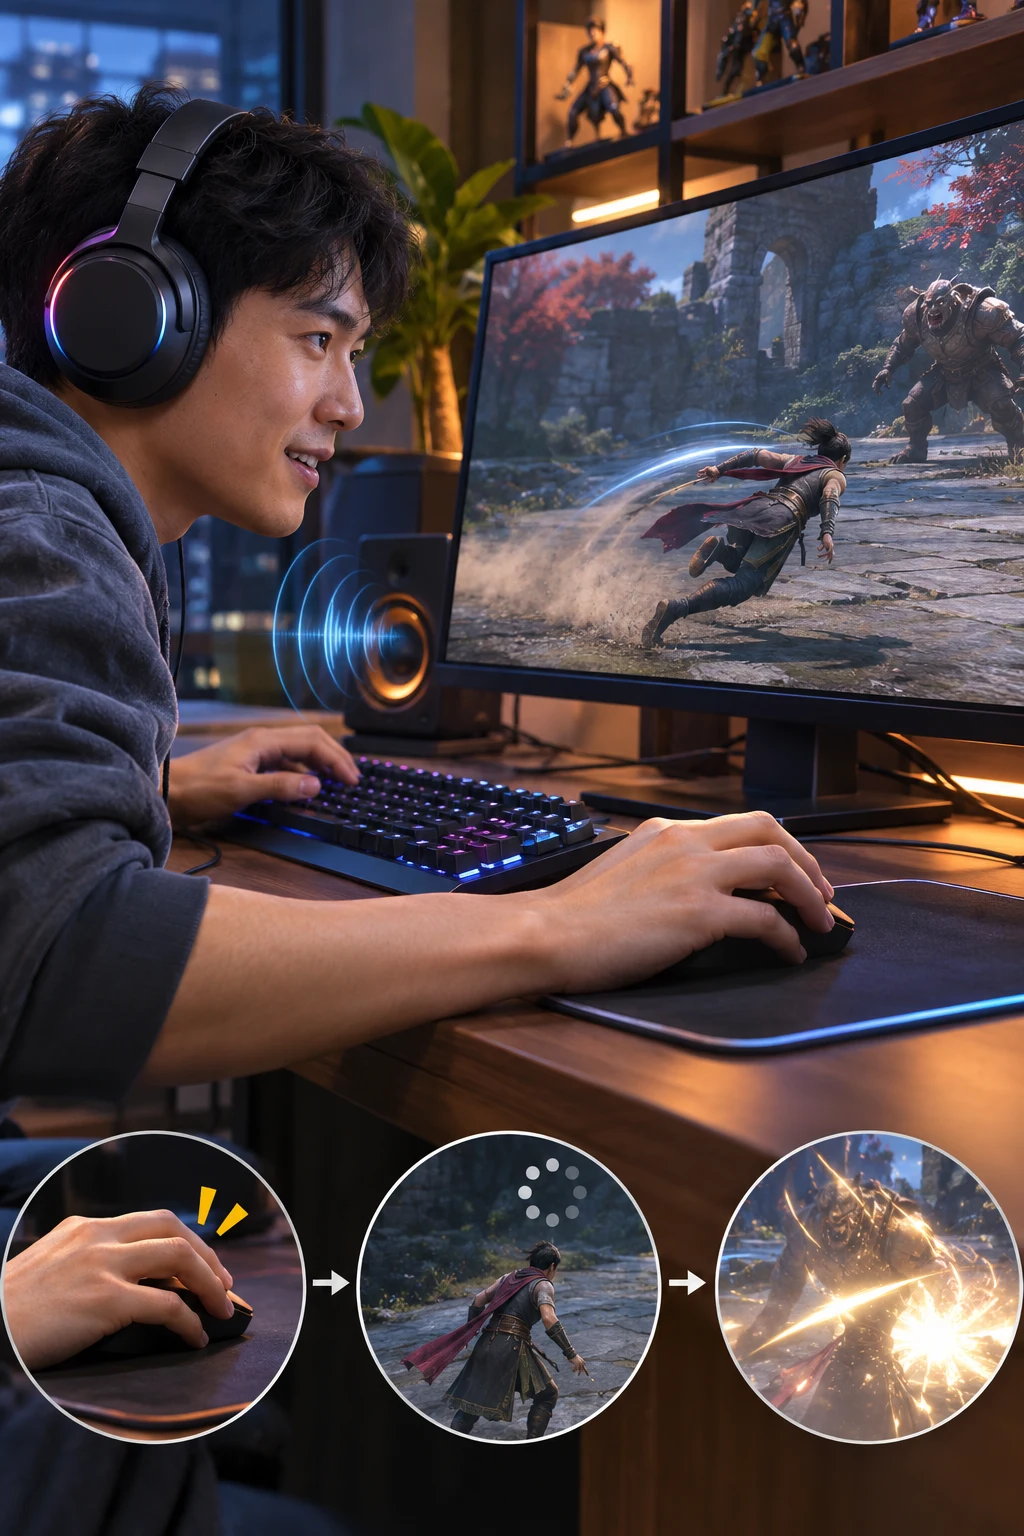
操作反馈是把一次输入的处理结果留成可观察痕迹的机制,不只是瞬时动画;它靠痕迹与输入的对应关系成立。若反馈一闪即过且没有留存,操作者无法事后核对是否生效,容易重复输入;正确做法是让关键反馈持续到状态改变或下一次相关输入。
 操作与反馈
输入映射是把连续输入按阈值切成离散动作的判定规则,不只是按键对照;它靠进入阈值与退出阈值分开设定成立。若只写方向不写阈值,轻推或临界抖动会被反复识别成触发与释放;正确做法是同时规定触发与释放的门槛及回差。
操作反馈是把一次输入的处理结果留成可观察痕迹的机制,不只是瞬时动画;它靠痕迹与输入的对应关系成立。若反馈一闪即过且没有留存,操作者无法事后核对是否生效,容易重复输入;正确做法是让关键反馈持续到状态改变或下一次相关输入。
 操作与反馈
操作反馈是把一次输入的处理结果留成可观察痕迹的机制,不只是瞬时动画;它靠痕迹与输入的对应关系成立。若反馈一闪即过且没有留存,操作者无法事后核对是否生效,容易重复输入;正确做法是让关键反馈持续到状态改变或下一次相关输入。
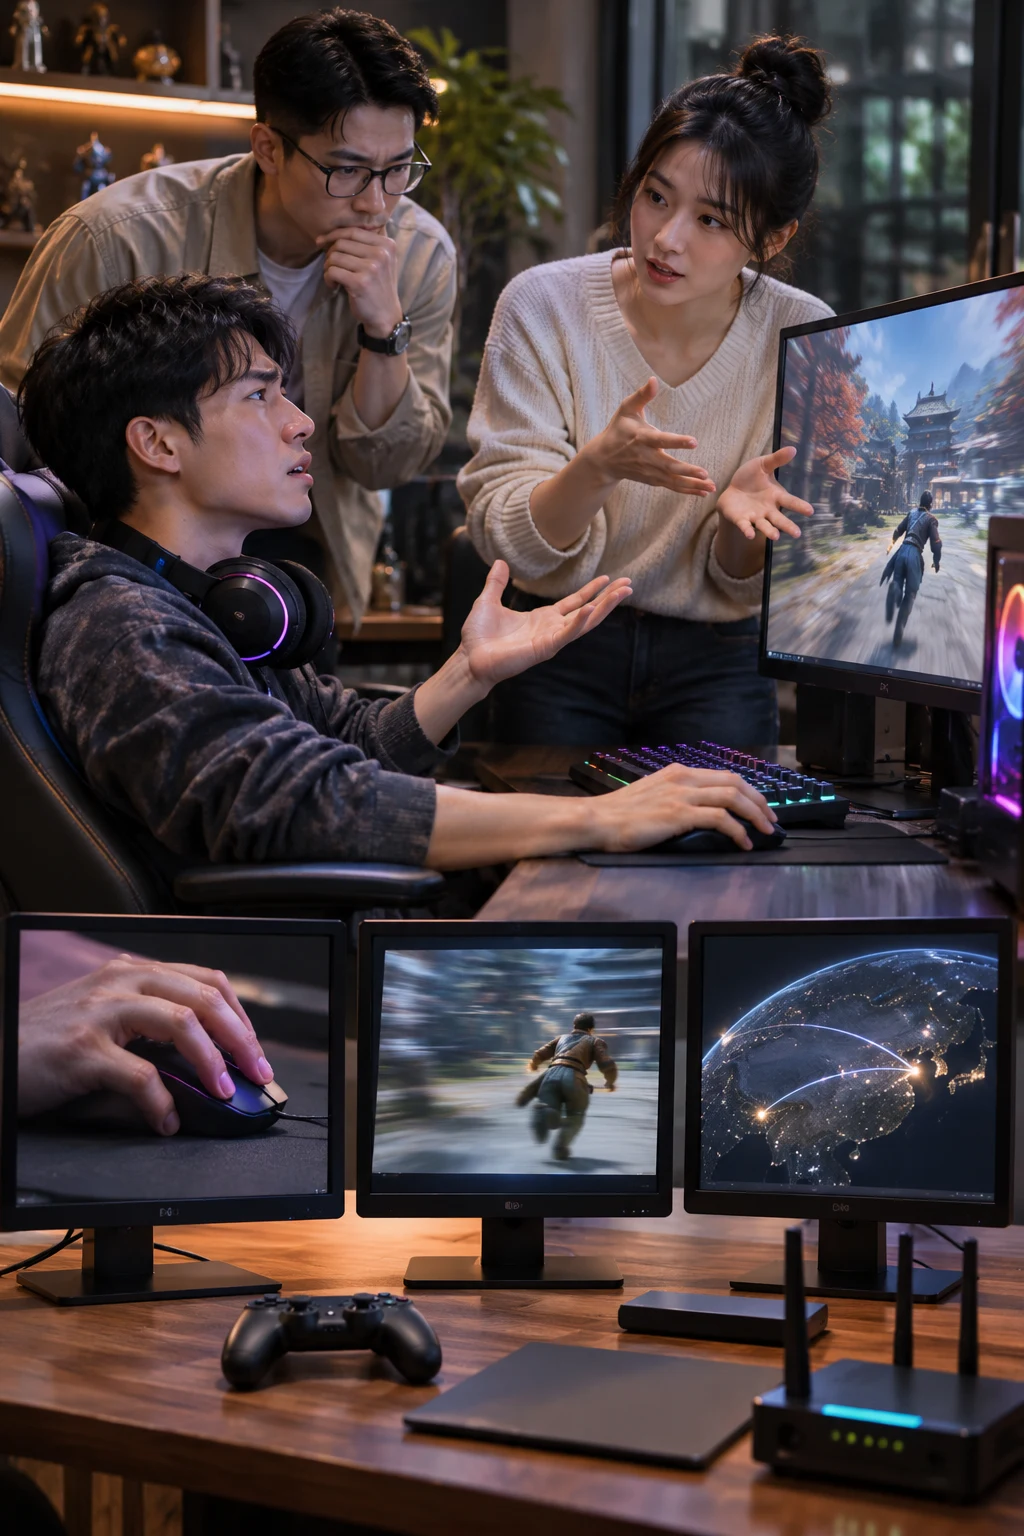
响应延迟是输入被系统接收后,到出现可归因于该输入的首个反馈之间的间隔;它衡量处理链路,而非操作者的反应速度。把它与准备时间或动画时长混在一起,会误判卡顿来源;应先固定反馈类型,再比较同一输入重复触发时的间隔是否稳定。
 操作与反馈
响应延迟是输入被系统接收后,到出现可归因于该输入的首个反馈之间的间隔;它衡量处理链路,而非操作者的反应速度。把它与准备时间或动画时长混在一起,会误判卡顿来源;应先固定反馈类型,再比较同一输入重复触发时的间隔是否稳定。
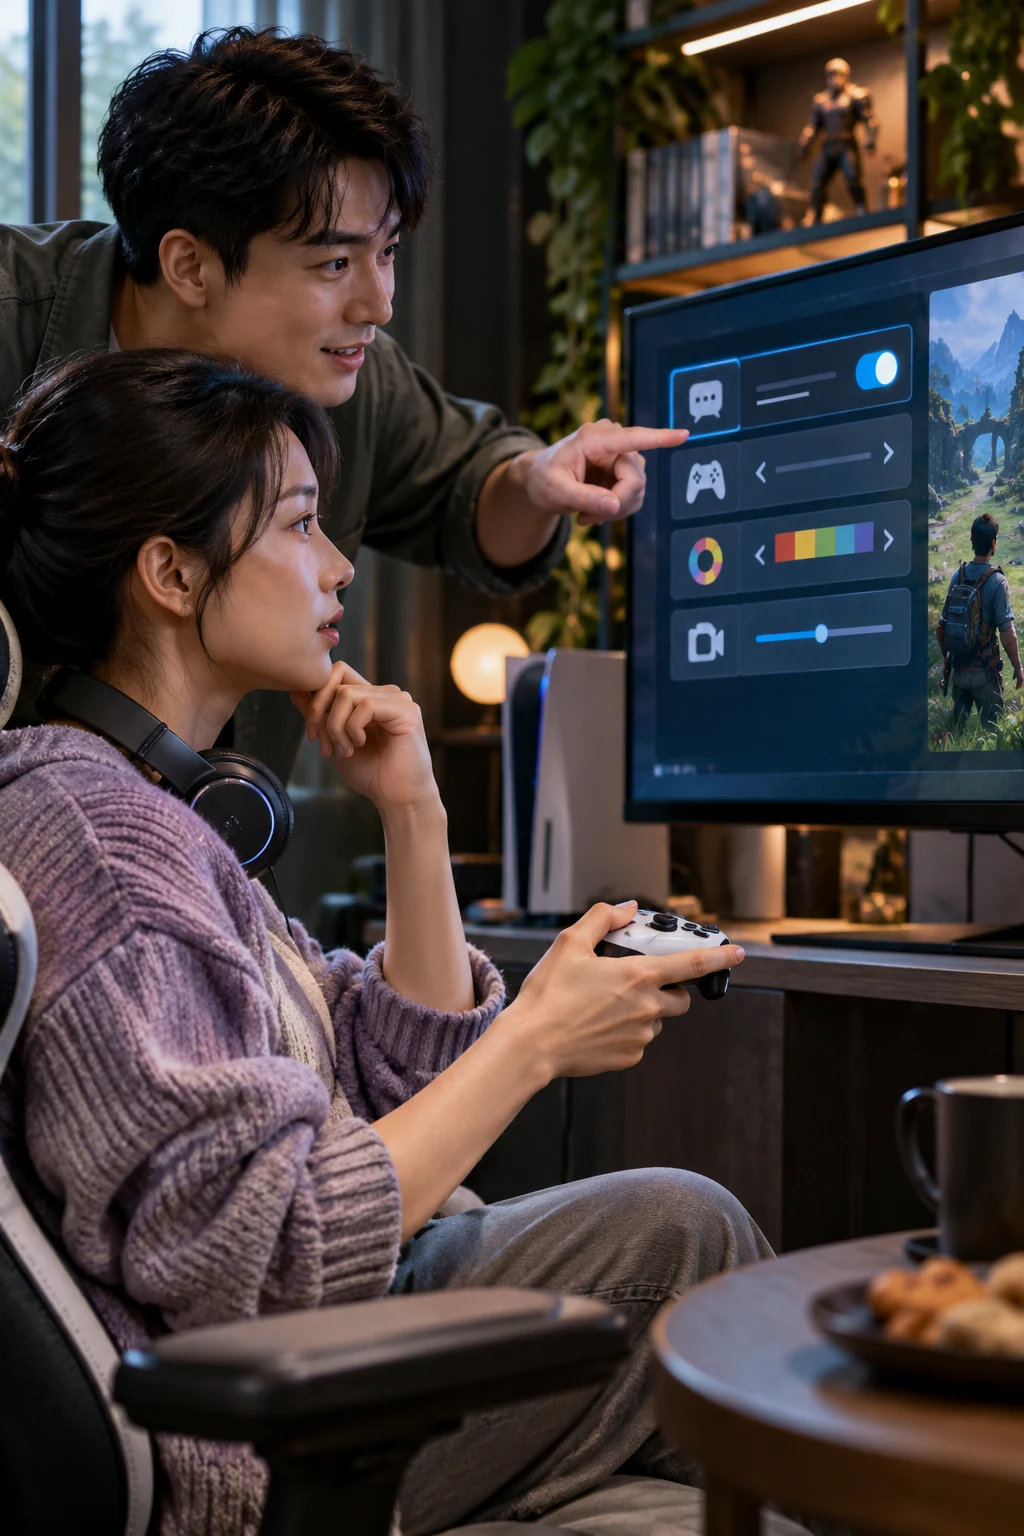
辅助设置是把操作条件差异从规则中分离出来的配置层,同一目标下允许多种操作方式;它成立的关键是各选项只改变达成方式,不改变胜负条件。误把任何能降低难度的开关都归入辅助,会混淆训练目标;核对时应分别记录开启前后完成动作的步骤数与判定结果,步骤可变而判定不变才算。
 操作与反馈
辅助设置是把操作条件差异从规则中分离出来的配置层,同一目标下允许多种操作方式;它成立的关键是各选项只改变达成方式,不改变胜负条件。误把任何能降低难度的开关都归入辅助,会混淆训练目标;核对时应分别记录开启前后完成动作的步骤数与判定结果,步骤可变而判定不变才算。
路径选择是在信息不完整时先锁定一条分支,其余分支的后续内容在本轮不再可获得;它靠选择前必须承担不确定性、选择后才逐步揭示后果成立。误把结局已知的路线挑选当作选择,会把执行当成决策;正确做法是记录选前可用的依据和选后揭示的信息,区分决策质量与结果运气。
操作与反馈输入映射是把连续输入按阈值切成离散动作的判定规则,不只是按键对照;它靠进入阈值与退出阈值分开设定成立。若只写方向不写阈值,轻推或临界抖动会被反复识别成触发与释放;正确做法是同时规定触发与释放的门槛及回差。
响应延迟是输入被系统接收后,到出现可归因于该输入的首个反馈之间的间隔;它衡量处理链路,而非操作者的反应速度。把它与准备时间或动画时长混在一起,会误判卡顿来源;应先固定反馈类型,再比较同一输入重复触发时的间隔是否稳定。
操作与反馈操作反馈是把一次输入的处理结果留成可观察痕迹的机制,不只是瞬时动画;它靠痕迹与输入的对应关系成立。若反馈一闪即过且没有留存,操作者无法事后核对是否生效,容易重复输入;正确做法是让关键反馈持续到状态改变或下一次相关输入。
辅助设置是把操作条件差异从规则中分离出来的配置层,同一目标下允许多种操作方式;它成立的关键是各选项只改变达成方式,不改变胜负条件。误把任何能降低难度的开关都归入辅助,会混淆训练目标;核对时应分别记录开启前后完成动作的步骤数与判定结果,步骤可变而判定不变才算。
操作与反馈响应延迟是输入被系统接收后,到出现可归因于该输入的首个反馈之间的间隔;它衡量处理链路,而非操作者的反应速度。把它与准备时间或动画时长混在一起,会误判卡顿来源;应先固定反馈类型,再比较同一输入重复触发时的间隔是否稳定。
路径选择是在信息不完整时先锁定一条分支,其余分支的后续内容在本轮不再可获得;它靠选择前必须承担不确定性、选择后才逐步揭示后果成立。误把结局已知的路线挑选当作选择,会把执行当成决策;正确做法是记录选前可用的依据和选后揭示的信息,区分决策质量与结果运气。
操作与反馈辅助设置是把操作条件差异从规则中分离出来的配置层,同一目标下允许多种操作方式;它成立的关键是各选项只改变达成方式,不改变胜负条件。误把任何能降低难度的开关都归入辅助,会混淆训练目标;核对时应分别记录开启前后完成动作的步骤数与判定结果,步骤可变而判定不变才算。
难度递进是同一任务目标下,可容许的错误空间随阶段推进而收窄,并且收窄不是由随机波动造成;成立条件是前后阶段能按同一标准重复比较。误把偶然失误当成难度变化,会错调参数;应重放相邻阶段并只改变一个条件,看失败是否稳定出现在同一环节。